In vielen Webanwendungen müssen Dateien verarbeitet und langfristig gespeichert werden. Bei der Definition der Systemarchitektur kommt deshalb immer wieder dieselbe Frage auf: Wo sollen diese Binary Large Objects (kurz Blobs) liegen? Im Folgenden zeigen wir, welche Nachteile es hat, Blobs in der Datenbank zu speichern, und welche Alternativen es gibt.
Einfache User Stories wie
Als Benutzer:in möchte ich ein Profilfoto hochladen können.
oder
Als Benutzer:in möchte ich meinem Domänenobjekt eine Excel- oder PDF-Datei anhängen können.
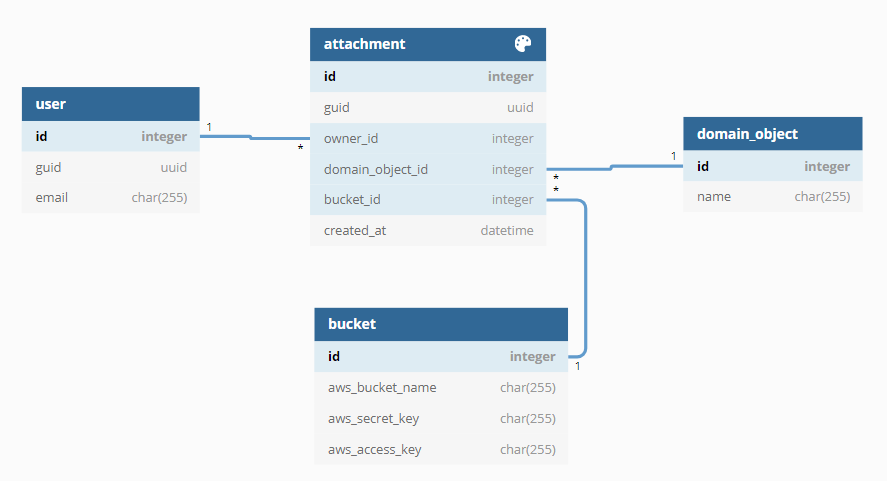
verleiten dazu, eine vermeintlich einfache technische Lösung zu wählen: das Profilfoto oder die Excel- bzw. PDF-Datei direkt in der Datenbank zu speichern. Der folgende Ausschnitt einer Datenbankmodellierung findet sich deshalb in vielen Anwendungen:
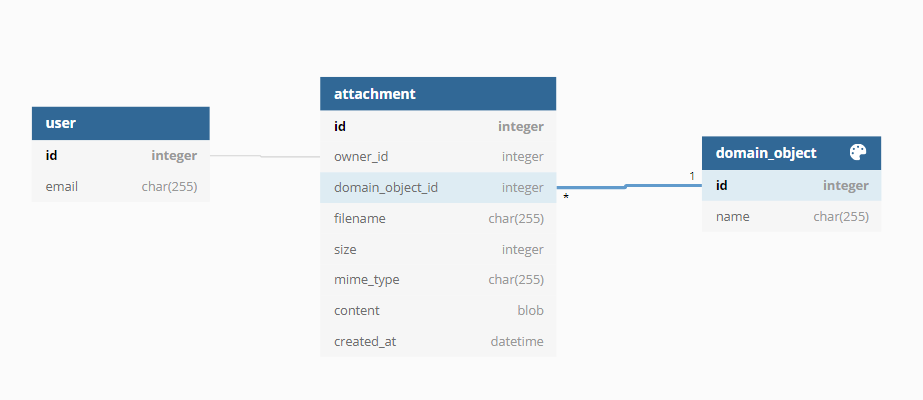
Je nach Framework ist das Speichern des Bytestreams in der Tabelle attachment schnell umgesetzt. Nachträglich nötige Berechtigungen für den Download lassen sich einfach ergänzen, die User Story ist erledigt. Während der Testphase oder beim Go-live mit wenigen Nutzer:innen und geringer Last läuft die Anwendung wie gewünscht. Der Auftraggeber ist vorerst zufrieden.
Was es bedeutet, Blobs in der Datenbank zu speichern
Direkte Konsequenzen
Durch die Dateianhänge in der Tabelle attachment wächst die Datenbank. Blobs tragen im Verhältnis zu den reinen (Text-)Daten am meisten zum Wachstum bei. Das bedeutet:
- Das Dateisystem, auf dem die Datenbank liegt (beispielsweise
/var/lib/postgres), läuft mit der Zeit voll. - Exporte der Datenbank dauern länger.
- Die Last bei der Replikation steigt.
Die Datenbank kann dabei deutlich schneller wachsen als geplant. Bei SaaS-Anwendungen passiert das oft in der Startphase durch eine schnell wachsende Nutzerbasis. Oder es haben sich bei der Implementierung Fehler eingeschlichen bzw. Randbedingungen wurden nicht bedacht:
- Bestehende Dateien werden bei einem erneuten Upload nicht ersetzt, sondern zusätzlich gespeichert.
- Es gibt kein Limit für die Größe angehängter Dateien.
Volllaufendes Dateisystem
Je nach Partitionierung kann ein volles Dateisystem dazu führen, dass du dich nicht mehr ohne Weiteres per SSH anmelden kannst. Im einfachsten Fall sind in der Datenbank keine Schreibzugriffe mehr möglich. Auch Änderungen an anderen Tabellen schlagen dann fehl, und die Anwendung ist nur noch eingeschränkt nutzbar.
Da sich die Blobs nicht einfach aus der Datenbank löschen lassen, musst du entweder das Dateisystem vergrößern oder die Datenbank auf ein Dateisystem mit freiem Speicherplatz umziehen.
Längere Exporte
Je mehr Daten in der Datenbank liegen, desto länger dauert ein Export. Kurzfristig ist das zu vernachlässigen, im Produktivbetrieb kann es langfristig zum Problem werden.
Kritischer wird es, wenn Daten aus der Produktivdatenbank regelmäßig anonymisiert und für die QS-Umgebung exportiert werden. In einem CI/CD-Prozess kann das mehrmals täglich passieren und erzeugt zusätzliche Last auf der Produktivdatenbank. Frag dich hier, ob du wirklich stunden- oder gar minutenaktuelle Daten brauchst. Andernfalls kannst du Exporte zwischenspeichern und wiederverwenden.
Muss der letzte Stand der Produktivdatenbank eingespielt werden, solltest du die Dateianhänge aus dem Export ausschließen. Je nach Umgebung ist das aufwendig und erhöht die Komplexität des Exports.
Höhere Last bei der Replikation
Das betrifft Anwendungen, bei denen eine horizontale Skalierung der Datenbank bereits vorgesehen ist: Zwischen Primary- und Secondary-Knoten entsteht mehr Replikationslast. Im ungünstigen Fall gerät die Replikation dadurch aus dem Takt.
Wiederherstellung einzelner Blobs
Aufgrund von Compliance-Anforderungen kann es nötig sein, Datensätze zu historisieren oder wiederherstellbar zu halten. Die Historisierung lässt sich umsetzen, indem für jeden neuen Blob ein neues Tupel gespeichert wird. Das bedeutet allerdings, dass jede Version eines Blobs vollständig in der Datenbank liegt.
Oracles Advanced LOB Deduplication erlaubt eine Deduplizierung. MySQL und PostgreSQL bieten ein solches Feature nicht.
Folgeprobleme in der Entwicklung
Die bisher beschriebenen Probleme wirken während der Entwicklung eher theoretisch. Im Betrieb sind ohnehin die Datenbankadministrator:innen oder das DevOps-Team zuständig.
Sobald aber Teile der Anwendung Performance-Probleme haben, wird zuerst das Entwicklungsteam gefragt. Das folgende Sequenzdiagramm zeigt den Ablauf, wenn Blobs aus der Datenbank geladen werden. Der Blob-Service steht dabei stellvertretend für einen Applikationsserver, einen Microservice, einen Webserver oder auch ein PHP-Skript.
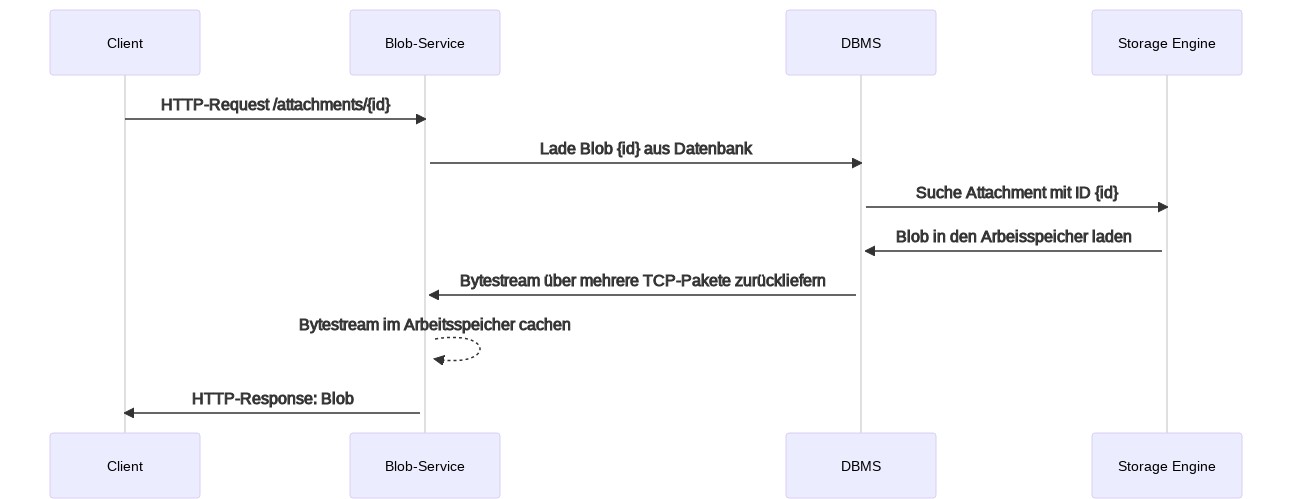
Bei jeder Anfrage eines Blobs sind also sowohl der Blob-Service als auch das Datenbankmanagementsystem beteiligt. Die Antwortzeiten steigen.
Speicherverbrauch
Für jeden angefragten Blob sucht der Service zuerst das zugehörige Tupel in der Datenbank. Das DBMS liefert den Datensatz über TCP zurück, der Service extrahiert den Blob und gibt ihn an den Web- oder Applikationsserver weiter.
Bei klassischen Anwendungen führt das zu hohem Arbeitsspeicherverbrauch: Der gesamte Bytestream muss während der Anfrage im Speicher gehalten werden. Bei einer 20 MB großen Datei belegen sowohl das DBMS als auch der Blob-Service zusätzlich 20 MB Arbeitsspeicher. Schon wenige gleichzeitige Anfragen können den Speicher vollständig auslasten.
Reaktive Anwendungen, etwa mit Spring WebFlux und R2DBC, können den Blob in einzelnen Chunks an den Client liefern und so den Speicherverbrauch minimieren. Dafür steigt die Komplexität der Anwendung.
Upload von Blobs
Neben dem Download musst du auch den Upload betrachten. Je nach Technologie müssen passende Parameter gesetzt sein, damit größere Dateien überhaupt hochgeladen werden können:
| Plattform | Konfigurationsparameter |
|---|---|
| PHP | upload_max_filesize und post_max_size |
| MySQL | max_allowed_packet |
| Spring Boot | spring.servlet.multipart.max-file-size und spring.servlet.multipart.max-request-size |
Wichtig ist außerdem ausreichend Arbeitsspeicher, sonst stürzen Java-Anwendungen mit java.lang.OutOfMemoryError: Java heap space ab. Bei PHP-Anwendungen musst du unter Umständen zusätzlich memory_limit anpassen, wenn die Datei im Speicher verarbeitet wird, etwa beim Komprimieren oder Skalieren von Bildern.
Caching
Um die Antwortzeiten zu senken, kann der Blob-Service Caching einsetzen. Die Blobs selbst im Arbeitsspeicher zu cachen ist wegen ihrer Größe nicht praktikabel. Stattdessen steuert der Blob-Service über den HTTP-Header Cache-Control, wann der Client eine neue Version anfragen soll.
Blobs außerhalb der Datenbank speichern
Um diese Probleme zu umgehen, kommen zwei Alternativen in Frage:
- Der Blob-Service liefert die Dateien direkt von der lokalen Festplatte oder einem verteilten Dateisystem (z. B. NFS oder EFS) aus. Die Metadaten bleiben in der Datenbank.
- Ein dedizierter Object Storage kommt zum Einsatz, etwa AWS S3, Azure Blob Storage, MinIO oder NetApp StorageGRID. Die Metadaten liegen in der Datenbank und/oder im Object Storage.
Auslieferung aus dem Dateisystem
Webserver sind darauf ausgelegt, statische Inhalte und damit auch hochgeladene Dateien performant auszuliefern. Kümmert sich der Blob-Service um die Auslieferung, geht das mit oder ohne Beteiligung des Web- oder Applikationsservers. Die Metadaten bleiben in der Datenbank, sodass die Anwendung Informationen zur Datei direkt anzeigen kann.
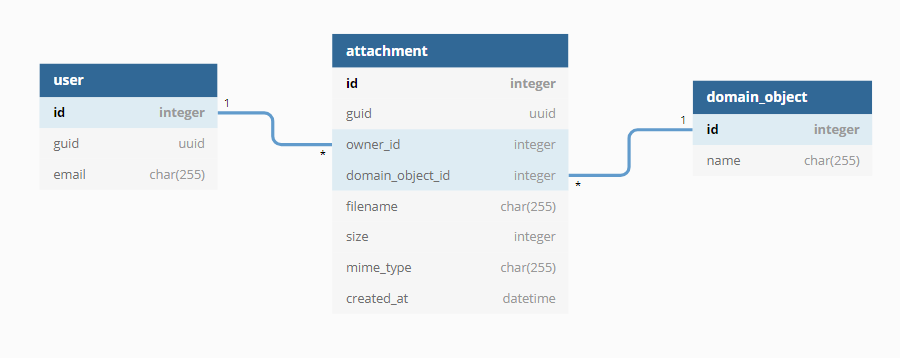
In beiden Fällen liegen die Dateien im angebundenen Dateisystem. Deine Backup-Strategie kann sie einbeziehen, sodass sich auch ältere Versionen wiederherstellen lassen.
Weiterleitung über eine URL
Die Anwendung erzeugt eine URL auf ein Verzeichnis, das der Web- oder Applikationsserver direkt ausliefert. Die Dateien liegen in einer Verzeichnisstruktur, die den Kontext enthält, etwa die GUID des aktuellen Mandanten. Der Dateiname wird durch eine zufällige ID ersetzt.
Vorteile:
- Vergleichsweise einfach umzusetzen
- Sehr performant, weil allein der Webserver die Dateien ausliefert
- Komprimierung während der Übertragung übernimmt direkt der Webserver
Nachteile:
- Eine Autorisierung ist nicht oder nur mit zusätzlichem Aufwand auf Seiten des Webservers möglich.
- Ein verschleierter Dateiname ist keine Sicherheitsmaßnahme.
- Verschleierte Dateinamen sind von Kund:innen oft nicht gewünscht.
Auslieferung durch den Blob-Service
Bei einer Anfrage erzeugt der Blob-Service anhand der Metadaten die passenden HTTP-Header inklusive des originalen Dateinamens. Anschließend lädt er die Datei und sendet den Bytestream an den Client.
Vorteile:
- Die Autorisierung erfolgt in der Anwendung. Das Durchprobieren von URLs führt ins Leere.
- Originaler Dateiname, MIME-Type und weitere Metadaten bleiben beim Download erhalten.
Nachteile:
- Während des Downloads wird zusätzlicher Arbeitsspeicher benötigt.
- Die Logik für den Download muss in der Anwendung implementiert werden.
Auslieferung über einen Object Storage
Object Storages sind darauf spezialisiert, einzelne Dateien über eine eindeutige URL bereitzustellen. Mit AWS S3 oder Azure Blob Storage lassen sich zeitlich begrenzt gültige URLs erzeugen, über die eine Datei herunter- oder hochgeladen werden kann. Je nach Anbieter gibt es Versionierung und die Möglichkeit, Dateien in langsamere und damit günstigere Speicherklassen zu verschieben.
Obwohl etwa S3 auch Metadaten speichern kann, werden diese oft zusätzlich in der Datenbank gehalten. Das reduziert die Anfragen an die S3-API.
Vorteile:
- Up- und Download liegen komplett außerhalb der Anwendung. Bei späterer Skalierung lässt sich zum Beispiel ein CDN wie CloudFront vorschalten.
- Die Datensicherung übernimmt der Object-Storage-Anbieter.
Nachteile:
- Unter Umständen Compliance-Probleme, wenn die Dateien bei einem Cloud-Anbieter liegen
- Je nach Produkt zusätzliche Kosten für Traffic und API-Anfragen
Risiko- und Kostenbetrachtung
| Speicherung in … | Risiko | Zu erwartende Kostenfaktoren |
|---|---|---|
| Datenbank | Hoch | Imageschaden beim Go-live durch schlechtes Laufzeitverhalten, Analyse der Performance-Probleme, vertikale Skalierung mit mehr CPU, Netzwerk, Arbeits- und Festplattenspeicher, spätere Migration der Daten in eine der anderen Lösungen |
| Lokales oder verteiltes Dateisystem | Mittel | Vertikale Skalierung mit mehr Festplattenspeicher; eine spätere Migration in einen Object Storage ist vergleichsweise einfach |
| Object Storage | Gering | Kosten für API-Anfragen und Traffic |
Fazit
Auch wenn es auf den ersten Blick verlockend aussieht, Blobs in der Datenbank zu speichern: Wir raten von dieser Architekturentscheidung ab. Je nach Risikoabwägung und Budget empfehlen wir entweder ein lokales oder verteiltes Dateisystem mit Auslieferung durch die Anwendung oder einen passenden Object Storage.
Du willst eine Architekturentscheidung wie diese absichern, bevor sie teuer wird? Genau dafür sind unser Advisory und unser Architektur-Review da.
Ursprünglich veröffentlicht am 3. September 2021.